返回代表工作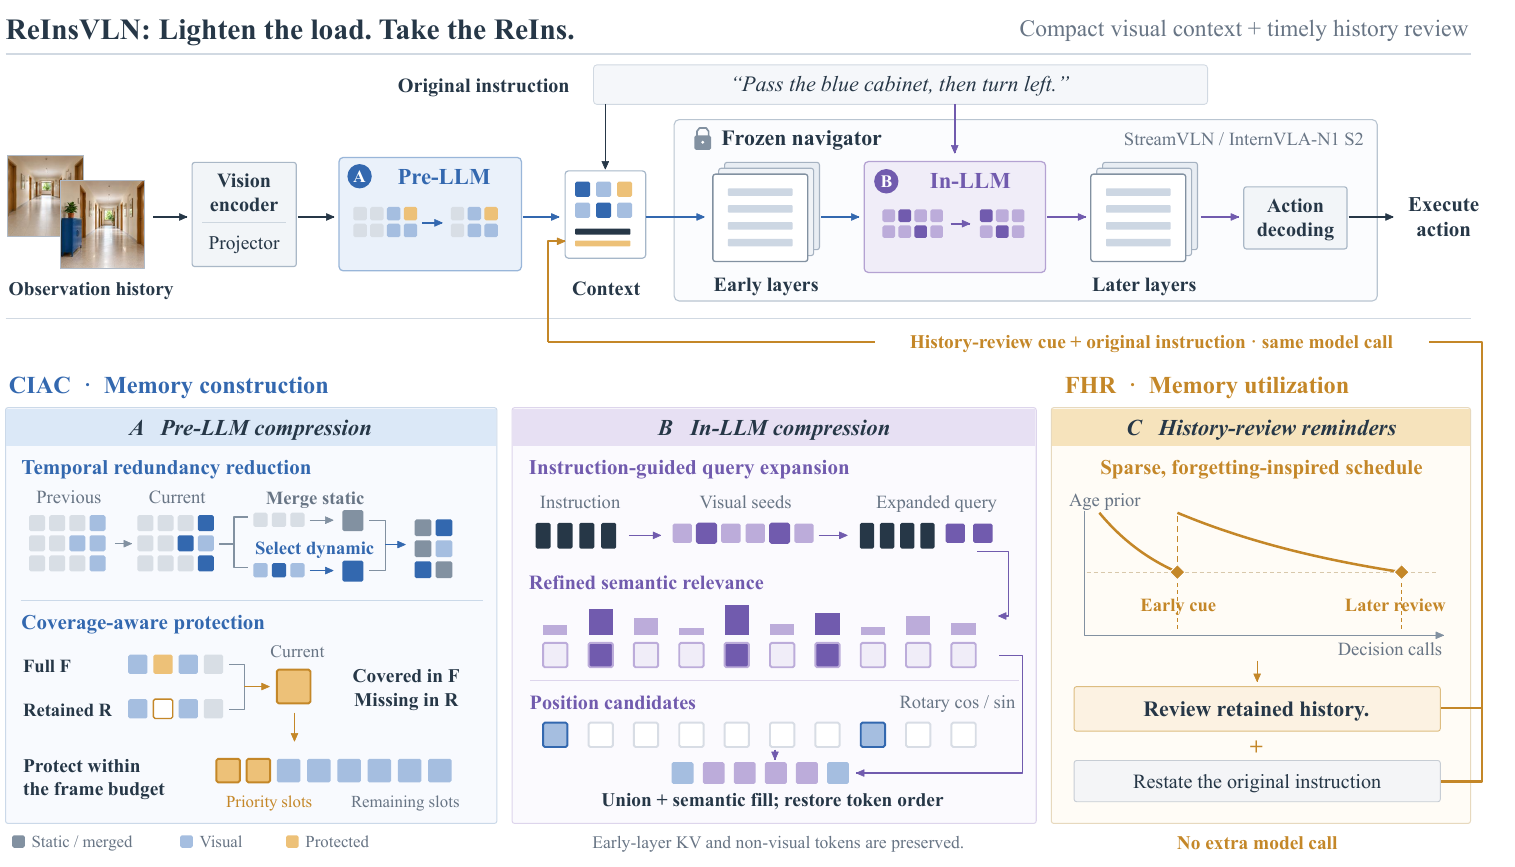
ReInsVLN
免训练视觉语言导航
ICRA 2027 · 在投
让导航模型保留关键的历史线索,并在需要时重新利用它们。
- 我的角色
- 第二作者(核心贡献者)
- 方法与工具
- PyTorch · StreamVLN · InternVLA-N1 · Habitat / R2R
01
问题与挑战
长轨迹带来冗余视觉上下文;即使线索仍在历史中,模型也可能没有在决策时使用。
02
关键贡献
我的贡献
负责视觉压缩模块的前期探索与接入,推进功能实现并协同迭代历史压缩策略;协同构建大小脑框架,适配多款 VLN 模型并打通推理与机器人执行的数据链路,完成 Go2 / G1 部署并参与实物实验。
方法流程
压缩历史观测:在进入语言模型前减少时间冗余,并保护已有记忆未充分覆盖的内容。
按指令筛选:在语言模型内部结合语义相关性与位置,保留关键视觉 token 并恢复原始顺序。
提醒与执行:按预设节奏回顾历史,将原生模型决策接入机器人执行链路。
03
实验结果
R2R Val-Unseen 全量 1,839 episodes:StreamVLN / InternVLA-N1 的 SR 达到 64.27% / 64.44%,较原生模型提高 8.48 / 3.37 个百分点。匹配观测测试中,InternVLA-N1 压缩配置的 prefill 延迟降低 21.77%,KV 存储降低 32.25%。
研究进行中,代码与论文暂未公开。